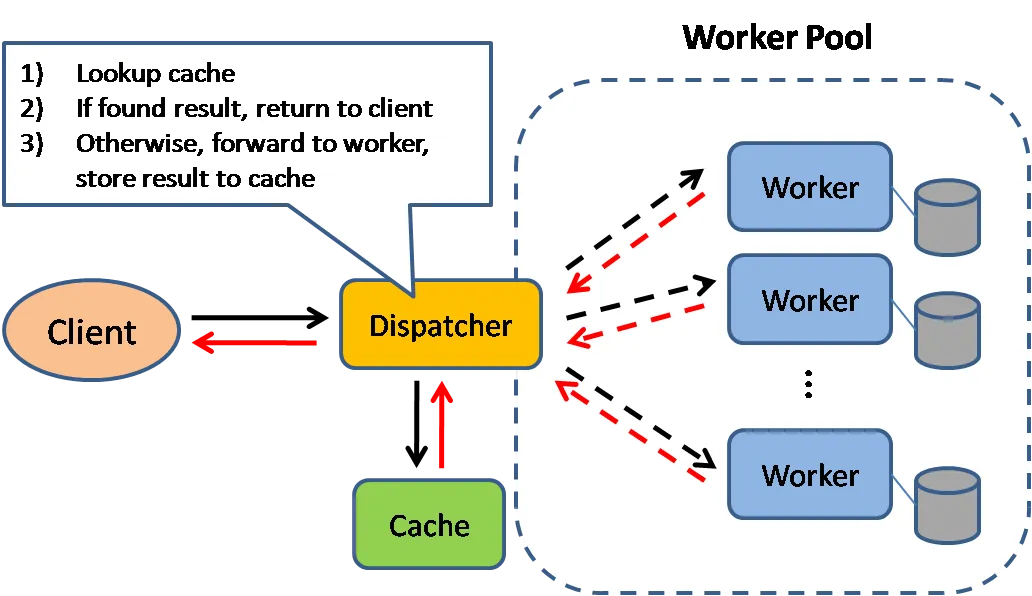
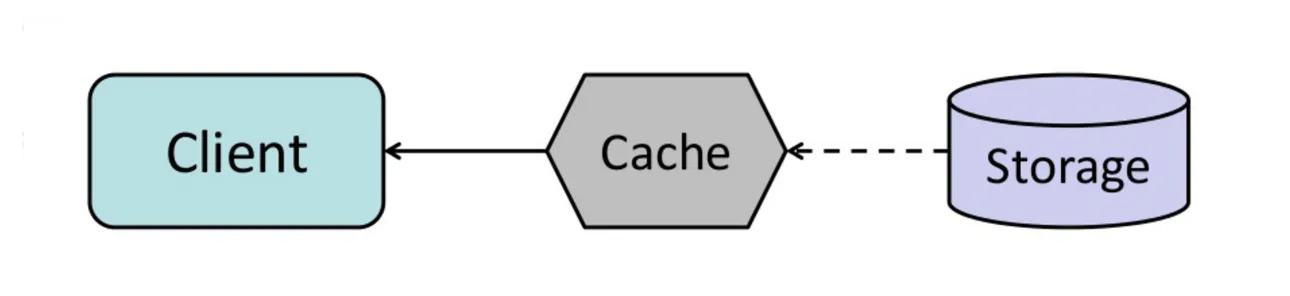
Bộ nhớ đệm (caching) giúp cải thiện thời gian tải trang và có thể giảm tải cho máy chủ và cơ sở dữ liệu. Trong mô hình này, bộ điều phối (dispatcher) trước hết sẽ tra xem request này đã từng được thực hiện chưa và cố tìm kết quả trước đó để trả về, nhằm tiết kiệm việc thực thi thật.
Khi dữ liệu có sẵn trong cache (hit), trả ngay; khi không (miss), lấy từ DB rồi lưu lại vào cache để lần sau nhanh hơn.
Cơ sở dữ liệu thường hoạt động tốt nhất khi các thao tác đọc và ghi được phân bố đều trên các phân vùng (partition) của nó. Những mục phổ biến (popular items) có thể làm lệch sự phân bố này, gây ra nút thắt cổ chai. Đặt một cache phía trước cơ sở dữ liệu có thể giúp hấp thụ tải không đều và các đợt tăng đột biến lưu lượng.
Cache phía client (Client caching)
Cache có thể nằm ở phía client (hệ điều hành hoặc trình duyệt), phía máy chủ, hoặc ở một tầng cache riêng biệt.
Reverse proxy và các cache như Varnish có thể phục vụ trực tiếp nội dung tĩnh và động. Máy chủ web cũng có thể cache các request, trả về response mà không cần liên hệ với máy chủ ứng dụng.
Cache ở cơ sở dữ liệu (Database caching)
Cơ sở dữ liệu của bạn thường đã có sẵn một mức cache nào đó trong cấu hình mặc định, được tối ưu cho trường hợp sử dụng chung chung. Tinh chỉnh các thiết lập này cho các kiểu sử dụng cụ thể có thể tăng hiệu năng thêm nữa.
Cache ở tầng ứng dụng (Application caching)
Các cache trong bộ nhớ (in-memory cache) như Memcached và Redis là các kho key-value nằm giữa ứng dụng và kho dữ liệu của bạn. Vì dữ liệu được giữ trong RAM, chúng nhanh hơn nhiều so với cơ sở dữ liệu thông thường, nơi dữ liệu được lưu trên đĩa. RAM hạn chế hơn đĩa, nên các thuật toán vô hiệu hóa cache (cache invalidation) như ít được dùng gần đây nhất (least recently used - LRU) có thể giúp loại bỏ các mục "nguội" (cold) và giữ dữ liệu "nóng" (hot) trong RAM.
Mỗi mục cache có một 'hạn dùng' (TTL); khi cache đầy, mục lâu chưa dùng nhất (LRU) bị loại trước để nhường chỗ cho mục mới.
Redis có thêm các tính năng sau:
Tùy chọn lưu bền (persistence)
Các cấu trúc dữ liệu dựng sẵn như tập hợp có thứ tự (sorted set) và danh sách (list)
Có nhiều mức bạn có thể cache, chia thành hai nhóm chung: truy vấn cơ sở dữ liệu (database queries) và đối tượng (objects):
Mức dòng (row level)
Mức truy vấn (query level)
Đối tượng hoàn chỉnh có thể tuần tự hóa (fully-formed serializable objects)
HTML đã render hoàn chỉnh (fully-rendered HTML)
Nhìn chung, bạn nên tránh cache dựa trên file, vì nó khiến việc nhân bản (cloning) và tự động mở rộng (auto-scaling) khó khăn hơn.
Cache ở mức truy vấn cơ sở dữ liệu
Mỗi khi truy vấn cơ sở dữ liệu, hãy băm (hash) câu truy vấn làm khóa và lưu kết quả vào cache. Cách này gặp vấn đề về hết hạn (expiration):
Khó xóa kết quả đã cache của các truy vấn phức tạp
Nếu một mẩu dữ liệu thay đổi, chẳng hạn một ô trong bảng, bạn cần xóa tất cả các truy vấn đã cache có thể chứa ô đã thay đổi đó
Cache ở mức đối tượng
Hãy nhìn dữ liệu của bạn như một đối tượng, tương tự cách bạn làm với mã ứng dụng. Để ứng dụng lắp ráp tập dữ liệu từ cơ sở dữ liệu thành một thể hiện của lớp (class instance) hoặc một (hay nhiều) cấu trúc dữ liệu:
Xóa đối tượng khỏi cache nếu dữ liệu nền của nó đã thay đổi
Cho phép xử lý bất đồng bộ: các worker lắp ráp đối tượng bằng cách dùng đối tượng mới nhất đang được cache
Gợi ý những thứ nên cache:
Phiên người dùng (user sessions)
Trang web đã render hoàn chỉnh
Luồng hoạt động (activity streams)
Dữ liệu đồ thị người dùng (user graph data)
Khi nào cập nhật cache
Vì bạn chỉ có thể lưu một lượng dữ liệu giới hạn trong cache, bạn cần xác định chiến lược cập nhật cache nào phù hợp nhất với trường hợp sử dụng của mình.
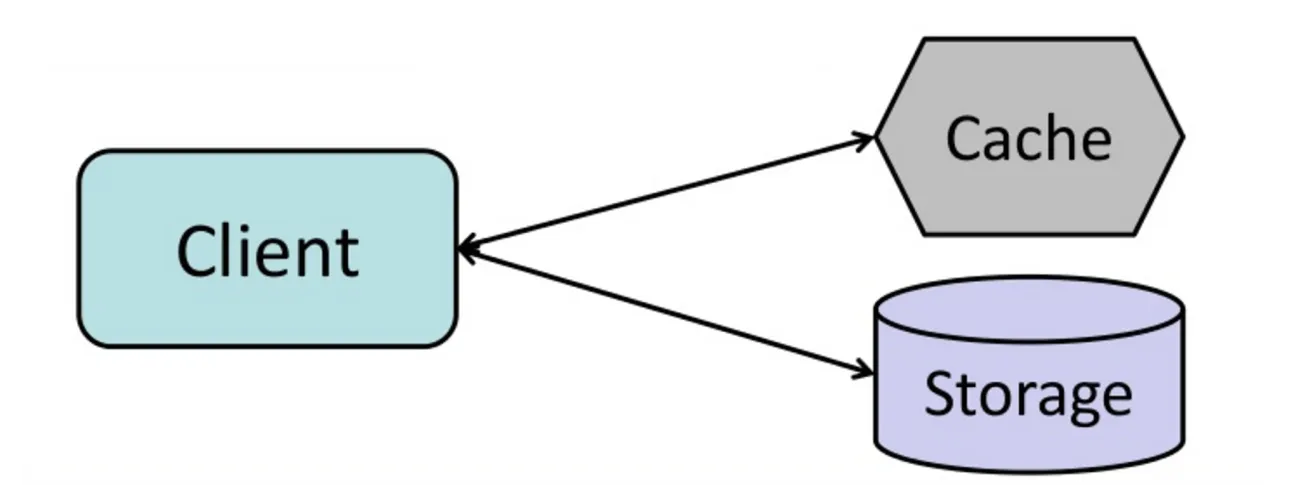
Ứng dụng chịu trách nhiệm đọc và ghi vào kho lưu trữ. Cache không tương tác trực tiếp với kho lưu trữ. Ứng dụng làm như sau:
Tìm mục trong cache, kết quả là trượt cache (cache miss)
Tải mục từ cơ sở dữ liệu
Thêm mục vào cache
Trả về mục
def get_user(self, user_id):
    user = cache.get("user.{0}", user_id)
    if user is None:
        user = db.query("SELECT * FROM users WHERE user_id = {0}", user_id)
        if user is not None:
            key = "user.{0}".format(user_id)
            cache.set(key, json.dumps(user))
    return user
Các lần đọc tiếp theo đối với dữ liệu đã được thêm vào cache sẽ nhanh. Cache-aside còn được gọi là tải lười (lazy loading). Chỉ dữ liệu được yêu cầu mới được cache, nhờ đó tránh làm đầy cache bằng dữ liệu không ai yêu cầu.
Nhược điểm: cache-aside
Mỗi lần trượt cache dẫn tới ba lượt đi-về, có thể gây độ trễ đáng kể.
Dữ liệu có thể bị cũ (stale) nếu nó được cập nhật trong cơ sở dữ liệu. Vấn đề này được giảm nhẹ bằng cách đặt thời gian sống (time-to-live - TTL) để buộc cập nhật mục cache, hoặc bằng cách dùng write-through.
Khi một node hỏng, nó được thay bằng một node mới, rỗng, làm tăng độ trễ.
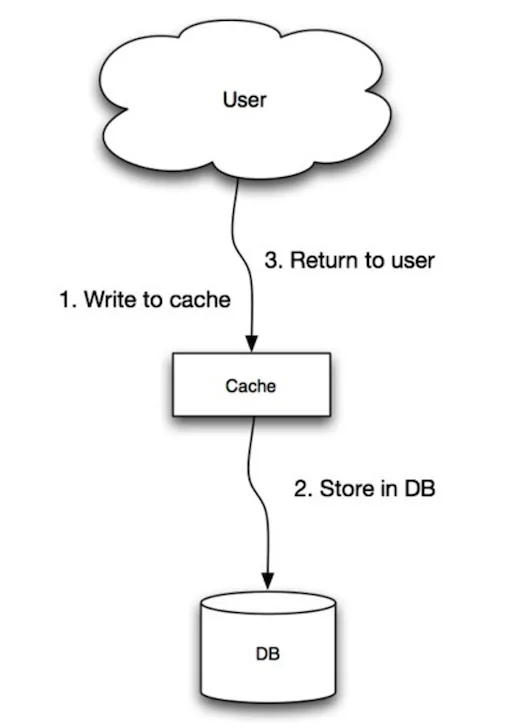
Ứng dụng dùng cache làm kho dữ liệu chính, đọc và ghi dữ liệu vào đó, còn cache chịu trách nhiệm đọc và ghi vào cơ sở dữ liệu:
Ứng dụng thêm/cập nhật mục trong cache
Cache ghi mục đó vào kho dữ liệu một cách đồng bộ
Trả về
Mã ứng dụng:
set_user(12345, {"foo":"bar"})
Mã cache:
def set_user(user_id, values):
    user = db.query("UPDATE Users WHERE id = {0}", user_id, values)
    cache.set(user_id, user)
Nhìn tổng thể, write-through là một thao tác chậm do phải ghi, nhưng các lần đọc tiếp theo đối với dữ liệu vừa ghi sẽ nhanh. Người dùng thường chấp nhận độ trễ khi cập nhật dữ liệu hơn là khi đọc dữ liệu. Dữ liệu trong cache không bị cũ.
Cache-aside: ứng dụng tự đọc/ghi cả cache lẫn DB. Write-through: ứng dụng chỉ nói chuyện với cache, cache tự đồng bộ xuống DB.
Nhược điểm: write-through
Khi một node mới được tạo ra do có node hỏng hoặc do mở rộng, node mới sẽ không cache mục nào cho tới khi mục đó được cập nhật trong cơ sở dữ liệu. Kết hợp cache-aside với write-through có thể giảm nhẹ vấn đề này.
Phần lớn dữ liệu được ghi có thể không bao giờ được đọc, điều này có thể giảm thiểu bằng TTL.