Cơ sở dữ liệu (Database)
Nội dung gốc
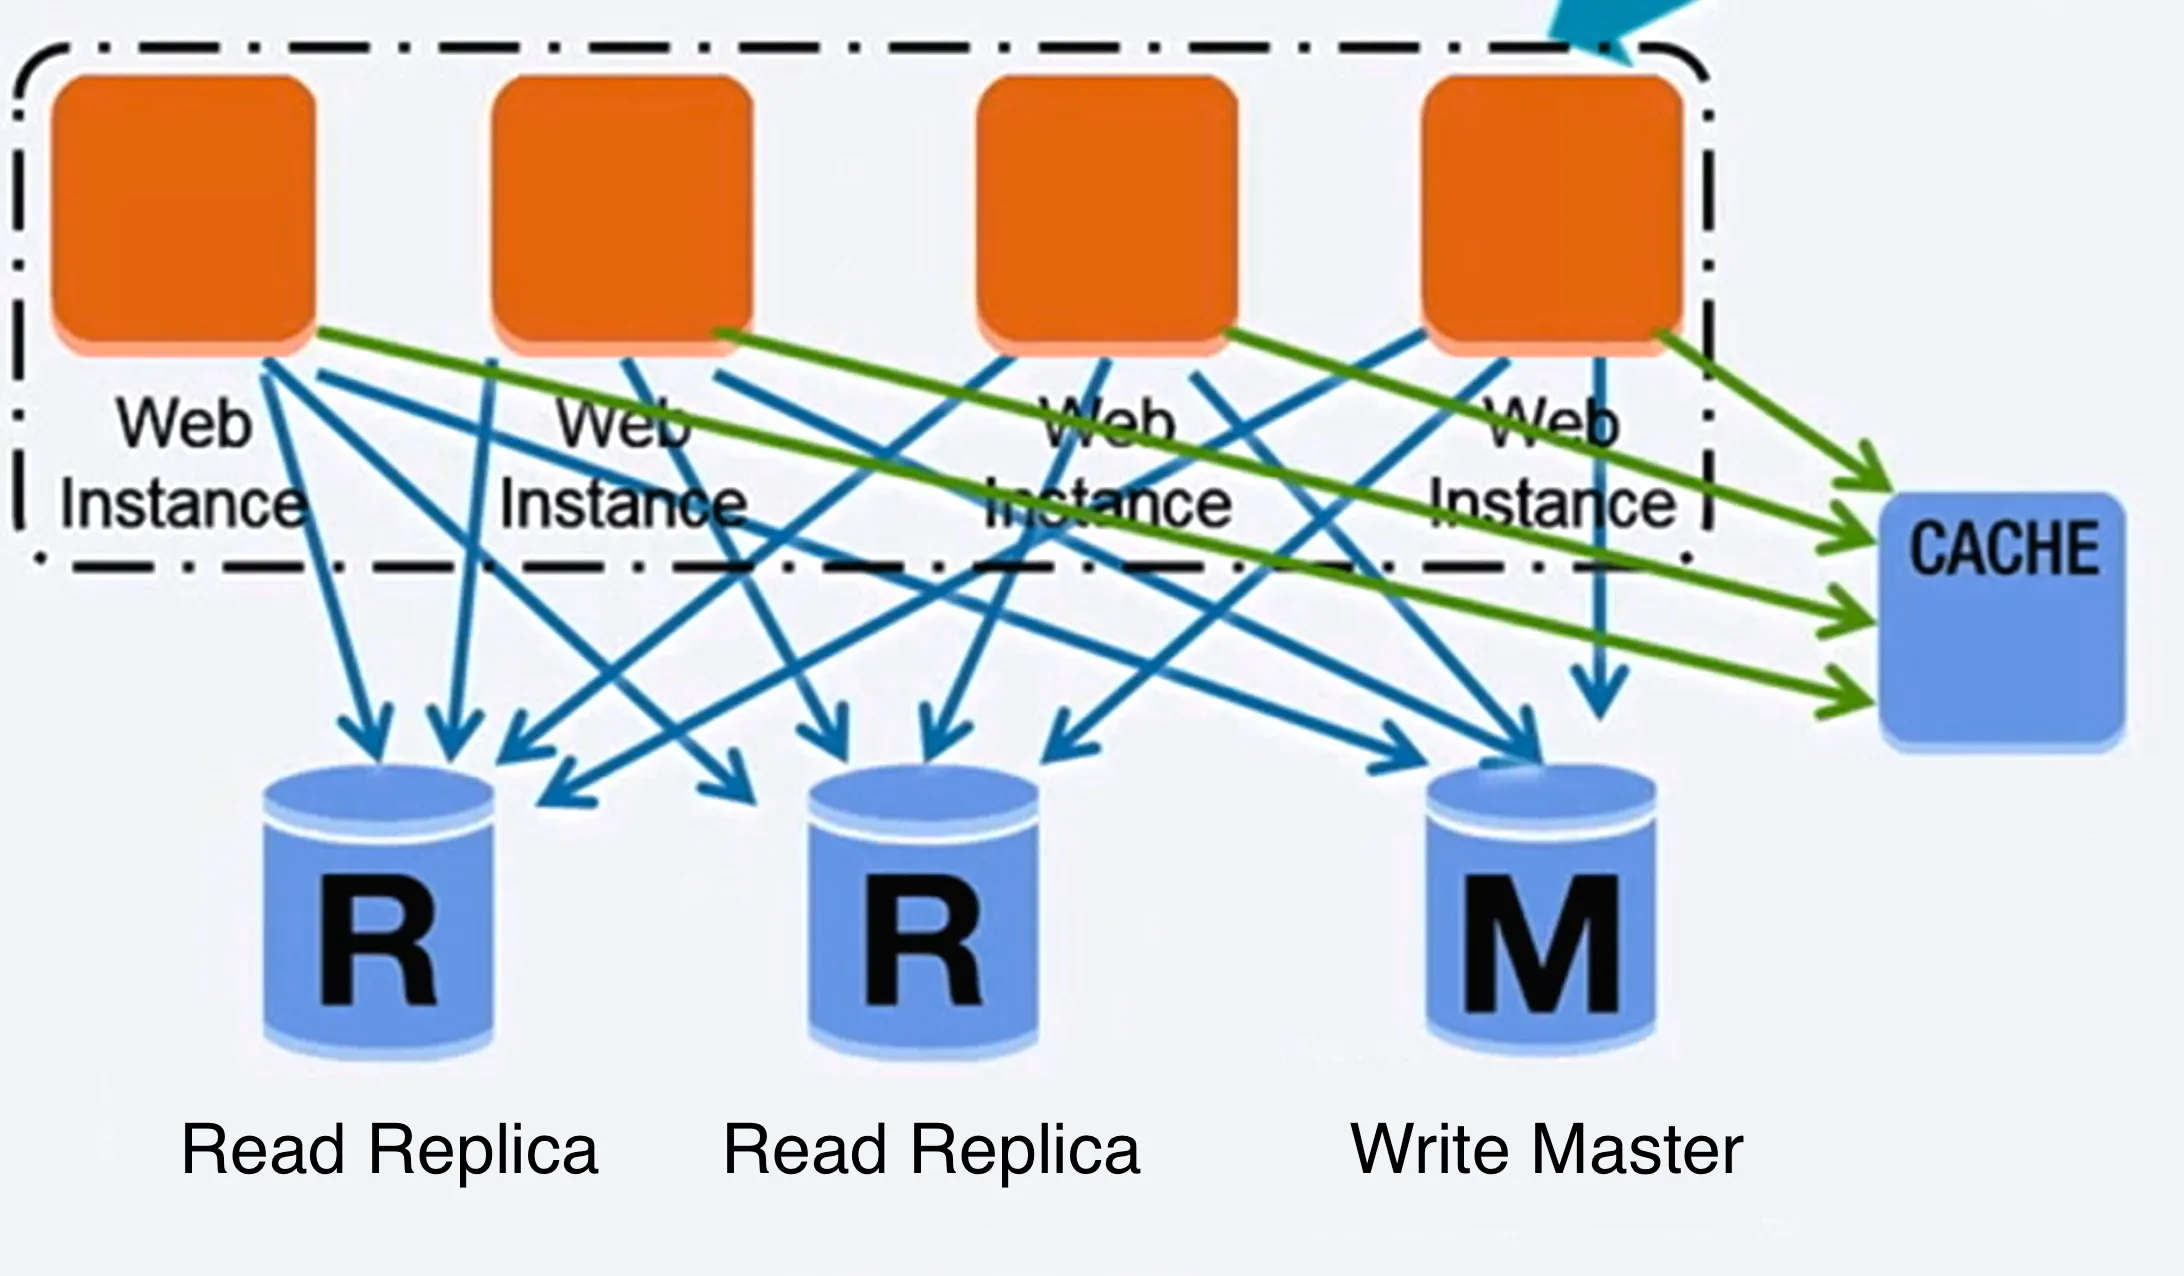
Hệ quản trị cơ sở dữ liệu quan hệ (RDBMS)
Một cơ sở dữ liệu quan hệ như SQL là một tập hợp các mục dữ liệu được tổ chức thành các bảng.
ACID là tập hợp các thuộc tính của giao dịch (transaction) trong cơ sở dữ liệu quan hệ.
- Tính nguyên tử (Atomicity) - Mỗi giao dịch hoặc thực hiện trọn vẹn, hoặc không thực hiện gì cả.
- Tính nhất quán (Consistency) - Mọi giao dịch đều đưa cơ sở dữ liệu từ một trạng thái hợp lệ sang một trạng thái hợp lệ khác.
- Tính cô lập (Isolation) - Thực thi các giao dịch đồng thời cho kết quả giống như khi các giao dịch được thực thi tuần tự.
- Tính bền vững (Durability) - Một khi giao dịch đã được xác nhận (commit), nó sẽ được giữ nguyên như vậy.
Có nhiều kỹ thuật để mở rộng một cơ sở dữ liệu quan hệ: nhân bản master-slave, nhân bản master-master, federation, sharding, phi chuẩn hóa (denormalization) và tinh chỉnh SQL (SQL tuning).
Nhân bản master-slave (Master-slave replication)
Master phục vụ cả đọc lẫn ghi, đồng thời nhân bản các thao tác ghi sang một hoặc nhiều slave; các slave chỉ phục vụ đọc. Slave cũng có thể nhân bản tiếp sang các slave khác theo dạng cây. Nếu master ngừng hoạt động, hệ thống có thể tiếp tục chạy ở chế độ chỉ đọc cho tới khi một slave được nâng cấp thành master hoặc một master mới được cấp phát.
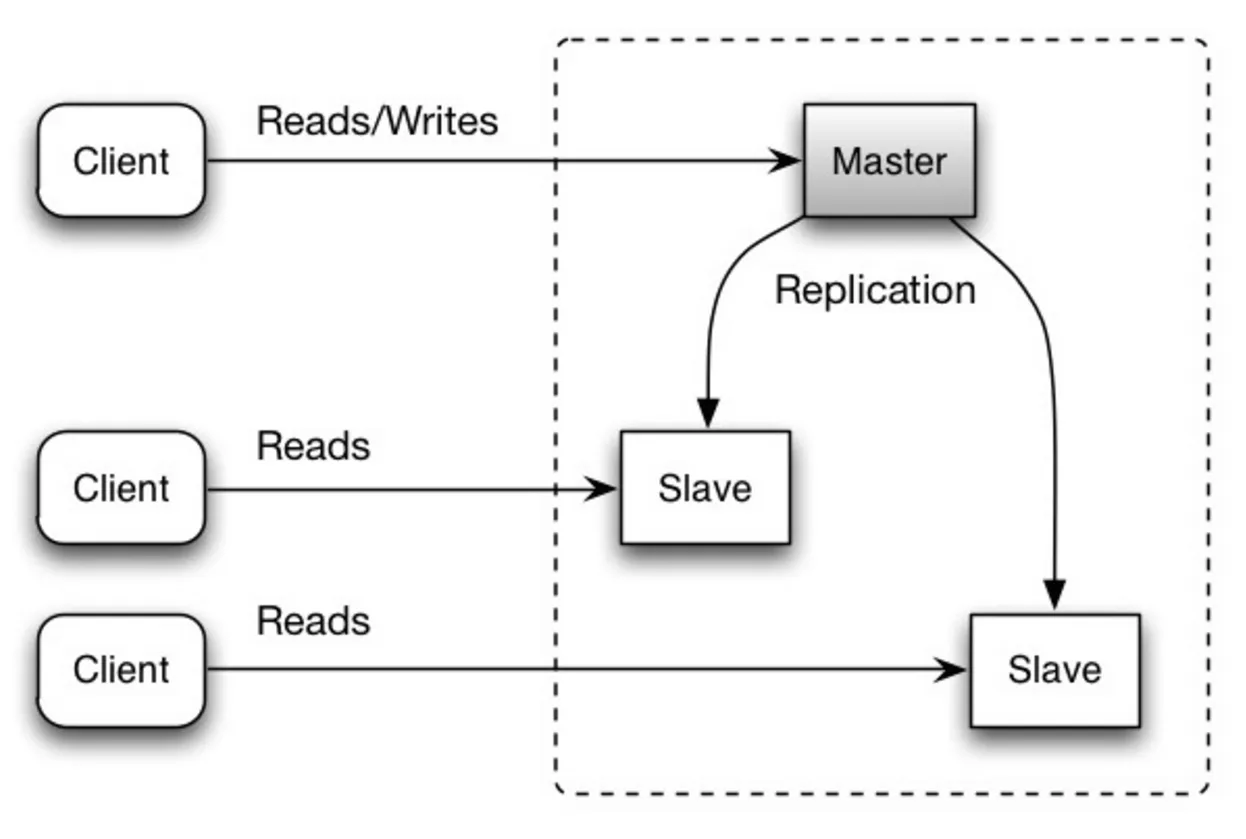
Nhược điểm: nhân bản master-slave
- Cần thêm logic để nâng cấp một slave thành master.
- Xem Nhược điểm: nhân bản cho các điểm liên quan tới cả master-slave lẫn master-master.
Nhân bản master-master (Master-master replication)
Cả hai master đều phục vụ đọc và ghi, và phối hợp với nhau khi ghi. Nếu một trong hai master ngừng hoạt động, hệ thống vẫn tiếp tục chạy với cả đọc lẫn ghi.
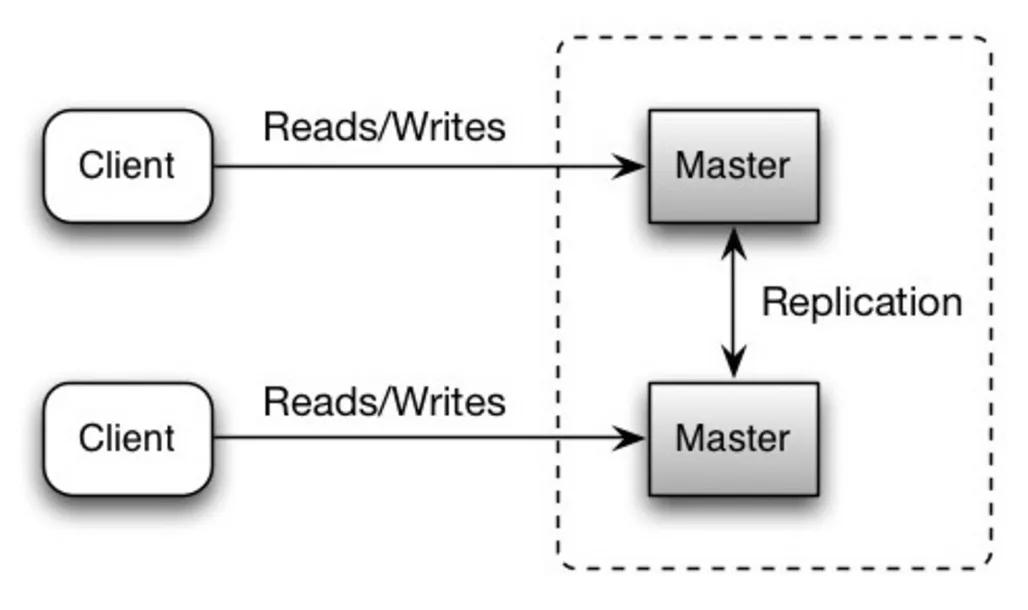
Nhược điểm: nhân bản master-master
- Bạn sẽ cần một bộ cân bằng tải (load balancer), hoặc phải sửa logic ứng dụng để quyết định ghi vào đâu.
- Hầu hết hệ thống master-master hoặc chỉ nhất quán lỏng lẻo (vi phạm ACID), hoặc có độ trễ ghi tăng lên do phải đồng bộ.
- Việc giải quyết xung đột (conflict resolution) càng trở nên quan trọng khi thêm nhiều node ghi và khi độ trễ tăng.
- Xem Nhược điểm: nhân bản cho các điểm liên quan tới cả master-slave lẫn master-master.
Nhược điểm: nhân bản
- Có nguy cơ mất dữ liệu nếu master hỏng trước khi dữ liệu vừa ghi kịp nhân bản sang các node khác.
- Các thao tác ghi được phát lại (replay) trên các bản sao đọc (read replica). Nếu có nhiều thao tác ghi, bản sao đọc có thể bị sa lầy vào việc phát lại ghi và không phục vụ được nhiều thao tác đọc.
- Càng nhiều slave đọc thì càng phải nhân bản nhiều, dẫn tới độ trễ nhân bản (replication lag) lớn hơn.
- Trên một số hệ thống, ghi vào master có thể sinh nhiều luồng (thread) để ghi song song, trong khi bản sao đọc chỉ hỗ trợ ghi tuần tự bằng một luồng duy nhất.
- Nhân bản làm tăng lượng phần cứng và tăng độ phức tạp.
Nguồn và đọc thêm: nhân bản
Federation
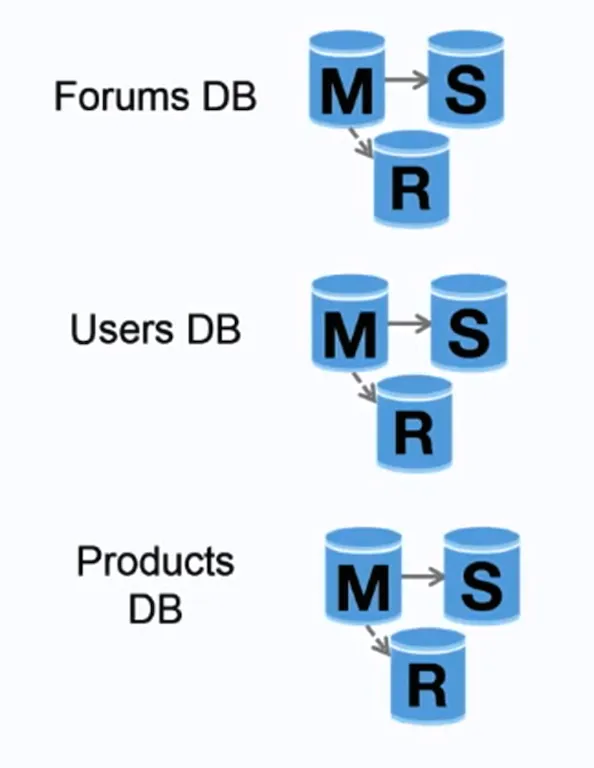
Federation (hay phân vùng theo chức năng - functional partitioning) tách cơ sở dữ liệu theo chức năng. Ví dụ, thay vì một cơ sở dữ liệu nguyên khối duy nhất, bạn có thể có ba cơ sở dữ liệu: forums, users và products, nhờ đó lưu lượng đọc và ghi vào mỗi cơ sở dữ liệu ít hơn, và vì vậy độ trễ nhân bản cũng thấp hơn. Cơ sở dữ liệu nhỏ hơn thì nhiều dữ liệu vừa trong bộ nhớ hơn, từ đó tăng tỉ lệ trúng cache (cache hit) nhờ tính cục bộ của cache (cache locality) tốt hơn. Vì không còn một master trung tâm duy nhất phải tuần tự hóa các thao tác ghi, bạn có thể ghi song song, tăng thông lượng (throughput).
Nhược điểm: federation
- Federation không hiệu quả nếu lược đồ (schema) của bạn đòi hỏi các hàm hoặc bảng khổng lồ.
- Bạn sẽ cần sửa logic ứng dụng để quyết định đọc và ghi vào cơ sở dữ liệu nào.
- Kết hợp (join) dữ liệu từ hai cơ sở dữ liệu phức tạp hơn khi phải dùng liên kết máy chủ (server link).
- Federation làm tăng lượng phần cứng và tăng độ phức tạp.
Nguồn và đọc thêm: federation
Sharding
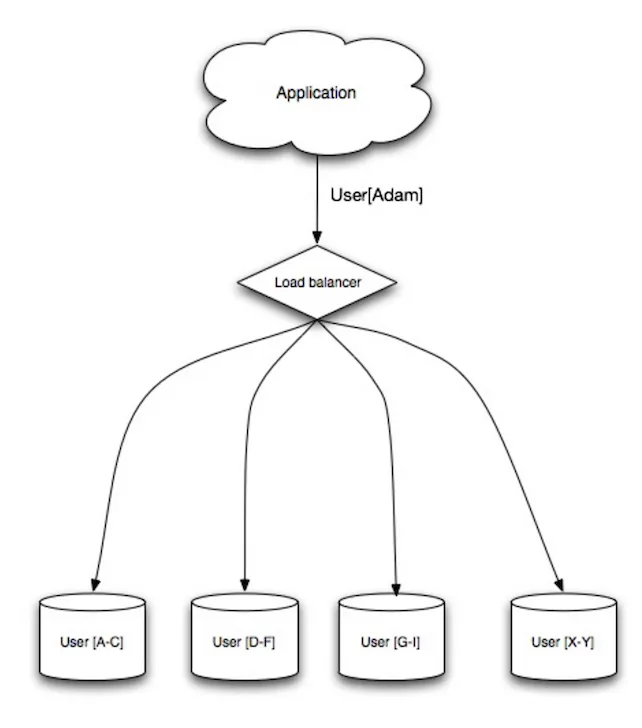
Sharding phân tán dữ liệu ra nhiều cơ sở dữ liệu khác nhau sao cho mỗi cơ sở dữ liệu chỉ quản lý một tập con của dữ liệu. Lấy cơ sở dữ liệu người dùng làm ví dụ: khi số người dùng tăng, ta thêm nhiều shard hơn vào cụm (cluster).
Tương tự ưu điểm của federation, sharding giúp giảm lưu lượng đọc và ghi, giảm nhân bản và tăng tỉ lệ trúng cache. Kích thước chỉ mục (index) cũng giảm, thường giúp cải thiện hiệu năng với truy vấn nhanh hơn. Nếu một shard ngừng hoạt động, các shard khác vẫn chạy, dù bạn sẽ muốn thêm một hình thức nhân bản nào đó để tránh mất dữ liệu. Giống federation, không có master trung tâm duy nhất tuần tự hóa các thao tác ghi, nên bạn có thể ghi song song và tăng thông lượng.
Cách phổ biến để shard một bảng người dùng là theo chữ cái đầu của họ (last name) người dùng hoặc theo vị trí địa lý của người dùng.
Nhược điểm: sharding
- Bạn sẽ cần sửa logic ứng dụng để làm việc với các shard, có thể dẫn tới những truy vấn SQL phức tạp.
- Dữ liệu có thể phân bố lệch giữa các shard. Ví dụ, một nhóm người dùng hoạt động mạnh (power user) nằm trên cùng một shard có thể làm shard đó chịu tải cao hơn các shard khác.
- Cân bằng lại (rebalancing) làm tăng thêm độ phức tạp. Một hàm sharding dựa trên băm nhất quán (consistent hashing) có thể giảm lượng dữ liệu phải chuyển đi.
- Kết hợp dữ liệu từ nhiều shard phức tạp hơn.
- Sharding làm tăng lượng phần cứng và tăng độ phức tạp.
Nguồn và đọc thêm: sharding
Phi chuẩn hóa (Denormalization)
Phi chuẩn hóa cố gắng cải thiện hiệu năng đọc với cái giá là giảm một phần hiệu năng ghi. Các bản sao dư thừa của dữ liệu được ghi vào nhiều bảng để tránh các phép join tốn kém. Một số RDBMS như PostgreSQL và Oracle hỗ trợ khung nhìn cụ thể hóa (materialized view), đảm nhận việc lưu thông tin dư thừa và giữ các bản sao dư thừa nhất quán với nhau.
Khi dữ liệu đã được phân tán bằng các kỹ thuật như federation và sharding, việc quản lý join xuyên trung tâm dữ liệu càng làm tăng độ phức tạp. Phi chuẩn hóa có thể giúp tránh phải thực hiện những phép join phức tạp như vậy.
Trong hầu hết hệ thống, số lượt đọc có thể áp đảo số lượt ghi theo tỉ lệ 100:1, thậm chí 1000:1. Một lượt đọc dẫn tới phép join phức tạp trong cơ sở dữ liệu có thể rất tốn kém, tiêu tốn đáng kể thời gian cho các thao tác đĩa.
Nhược điểm: phi chuẩn hóa
- Dữ liệu bị trùng lặp.
- Các ràng buộc (constraint) có thể giúp các bản sao dư thừa luôn đồng bộ, nhưng điều đó làm tăng độ phức tạp của thiết kế cơ sở dữ liệu.
- Một cơ sở dữ liệu phi chuẩn hóa chịu tải ghi nặng có thể chạy kém hơn phiên bản chuẩn hóa tương ứng.
Nguồn và đọc thêm: phi chuẩn hóa
Tinh chỉnh SQL (SQL tuning)
Tinh chỉnh SQL là một chủ đề rộng và đã có nhiều cuốn sách được viết để làm tài liệu tham khảo.
Điều quan trọng là phải đo hiệu năng (benchmark) và phân tích hiệu năng (profile) để mô phỏng và phát hiện nút thắt cổ chai (bottleneck).
- Benchmark - Mô phỏng tình huống tải cao bằng các công cụ như ab.
- Profile - Bật các công cụ như nhật ký truy vấn chậm (slow query log) để giúp theo dõi các vấn đề hiệu năng.
Benchmark và profile có thể dẫn bạn tới các tối ưu sau.
Siết chặt lược đồ (Tighten up the schema)
- MySQL ghi xuống đĩa theo các khối liền kề để truy cập nhanh.
- Dùng
CHARthay choVARCHARvới các trường có độ dài cố định.CHARcho phép truy cập ngẫu nhiên nhanh, trong khi vớiVARCHAR, bạn phải tìm điểm kết thúc của một chuỗi rồi mới chuyển sang chuỗi tiếp theo được.
- Dùng
TEXTcho các khối văn bản lớn như bài blog.TEXTcũng cho phép tìm kiếm boolean. Dùng trườngTEXTsẽ lưu trên đĩa một con trỏ dùng để định vị khối văn bản. - Dùng
INTcho các số lớn tới 2^32, tức khoảng 4 tỷ. - Dùng
DECIMALcho tiền tệ để tránh lỗi biểu diễn số thực dấu phẩy động (floating point). - Tránh lưu các
BLOBSlớn, thay vào đó hãy lưu vị trí để lấy đối tượng. VARCHAR(255)là số ký tự lớn nhất có thể đếm bằng một số 8 bit, thường giúp tận dụng tối đa một byte trong một số RDBMS.- Đặt ràng buộc
NOT NULLở những chỗ phù hợp để cải thiện hiệu năng tìm kiếm.
Dùng chỉ mục tốt (Use good indices)
- Các cột bạn truy vấn (
SELECT,GROUP BY,ORDER BY,JOIN) có thể nhanh hơn nhờ chỉ mục. - Chỉ mục thường được biểu diễn dưới dạng B-tree tự cân bằng, giữ dữ liệu có thứ tự và cho phép tìm kiếm, truy cập tuần tự, chèn và xóa trong thời gian logarit.
- Đặt chỉ mục có thể giữ dữ liệu trong bộ nhớ, đòi hỏi nhiều không gian hơn.
- Thao tác ghi cũng có thể chậm hơn vì chỉ mục cũng cần được cập nhật.
- Khi nạp lượng lớn dữ liệu, có thể sẽ nhanh hơn nếu tắt chỉ mục, nạp dữ liệu, rồi dựng lại chỉ mục.
Tránh các phép join tốn kém
- Phi chuẩn hóa ở những chỗ hiệu năng đòi hỏi.
Phân vùng bảng (Partition tables)
- Tách một bảng bằng cách đưa các điểm nóng (hot spot) sang một bảng riêng để giúp giữ nó trong bộ nhớ.
Tinh chỉnh query cache
- Trong một số trường hợp, query cache có thể gây ra vấn đề hiệu năng.
Nguồn và đọc thêm: tinh chỉnh SQL
- Tips for optimizing MySQL queries
- Is there a good reason i see VARCHAR(255) used so often?
- How do null values affect performance?
- Slow query log
NoSQL
NoSQL là tập hợp các mục dữ liệu được biểu diễn trong một kho khóa - giá trị (key-value store), kho tài liệu (document store), kho cột rộng (wide column store) hoặc cơ sở dữ liệu đồ thị (graph database). Dữ liệu được phi chuẩn hóa, và các phép join thường được thực hiện trong code ứng dụng. Hầu hết các kho NoSQL không có giao dịch ACID thực sự và ưu tiên nhất quán cuối cùng (eventual consistency).
BASE thường được dùng để mô tả các thuộc tính của cơ sở dữ liệu NoSQL. So với định lý CAP, BASE chọn tính sẵn sàng thay vì tính nhất quán.
- Basically available (về cơ bản luôn sẵn sàng) - hệ thống đảm bảo tính sẵn sàng.
- Soft state (trạng thái mềm) - trạng thái của hệ thống có thể thay đổi theo thời gian, kể cả khi không có đầu vào.
- Eventual consistency (nhất quán cuối cùng) - hệ thống sẽ trở nên nhất quán sau một khoảng thời gian, với điều kiện trong khoảng đó hệ thống không nhận thêm đầu vào.
Ngoài việc chọn giữa SQL hay NoSQL, cũng nên hiểu loại cơ sở dữ liệu NoSQL nào phù hợp nhất với (các) trường hợp sử dụng của bạn. Phần tiếp theo sẽ điểm qua kho khóa - giá trị, kho tài liệu, kho cột rộng và cơ sở dữ liệu đồ thị.
Kho khóa - giá trị (Key-value store)
Trừu tượng hóa: bảng băm (hash table)
Một kho khóa - giá trị thường cho phép đọc và ghi trong O(1), và thường được lưu trên bộ nhớ hoặc SSD. Kho dữ liệu có thể giữ các khóa theo thứ tự từ điển (lexicographic order), cho phép truy xuất hiệu quả một dải khóa. Kho khóa - giá trị có thể cho phép lưu siêu dữ liệu (metadata) đi kèm giá trị.
Kho khóa - giá trị cho hiệu năng cao và thường được dùng cho các mô hình dữ liệu đơn giản hoặc dữ liệu thay đổi nhanh, chẳng hạn một tầng cache trong bộ nhớ. Vì chúng chỉ cung cấp một tập thao tác hạn chế, độ phức tạp bị đẩy sang tầng ứng dụng nếu cần thêm thao tác.
Kho khóa - giá trị là nền tảng cho các hệ thống phức tạp hơn như kho tài liệu, và trong một số trường hợp là cả cơ sở dữ liệu đồ thị.
Nguồn và đọc thêm: kho khóa - giá trị
Kho tài liệu (Document store)
Trừu tượng hóa: kho khóa - giá trị với giá trị là các tài liệu
Kho tài liệu xoay quanh các tài liệu (XML, JSON, nhị phân, v.v.), trong đó một tài liệu lưu toàn bộ thông tin của một đối tượng. Kho tài liệu cung cấp API hoặc ngôn ngữ truy vấn để truy vấn dựa trên cấu trúc bên trong của chính tài liệu. Lưu ý: nhiều kho khóa - giá trị có tính năng làm việc với siêu dữ liệu của giá trị, khiến ranh giới giữa hai kiểu lưu trữ này trở nên mờ nhạt.
Tùy vào cách hiện thực bên dưới, tài liệu được tổ chức theo bộ sưu tập (collection), thẻ (tag), siêu dữ liệu hoặc thư mục. Dù các tài liệu có thể được tổ chức hoặc nhóm lại với nhau, chúng vẫn có thể có những trường hoàn toàn khác nhau.
Một số kho tài liệu như MongoDB và CouchDB cũng cung cấp một ngôn ngữ giống SQL để thực hiện các truy vấn phức tạp. DynamoDB hỗ trợ cả khóa - giá trị lẫn tài liệu.
Kho tài liệu mang lại tính linh hoạt cao và thường được dùng để làm việc với dữ liệu thỉnh thoảng thay đổi.
Nguồn và đọc thêm: kho tài liệu
Kho cột rộng (Wide column store)
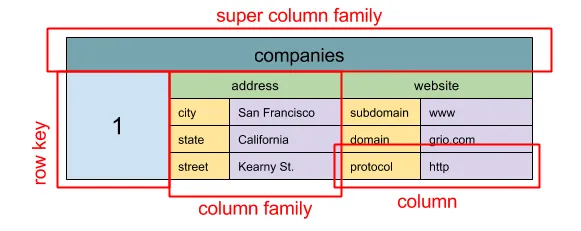
Trừu tượng hóa: map lồng nhau
ColumnFamily<RowKey, Columns<ColKey, Value, Timestamp>>
Đơn vị dữ liệu cơ bản của kho cột rộng là một cột (cặp tên/giá trị). Các cột có thể được nhóm thành họ cột (column family, tương tự một bảng SQL). Siêu họ cột (super column family) lại nhóm các họ cột với nhau. Bạn có thể truy cập từng cột độc lập bằng khóa hàng (row key), và các cột có cùng khóa hàng tạo thành một hàng. Mỗi giá trị kèm một dấu thời gian (timestamp) dùng để quản lý phiên bản và giải quyết xung đột.
Google giới thiệu Bigtable là kho cột rộng đầu tiên, có ảnh hưởng tới HBase mã nguồn mở (thường dùng trong hệ sinh thái Hadoop) và Cassandra của Facebook. Các kho như BigTable, HBase và Cassandra giữ khóa theo thứ tự từ điển, cho phép truy xuất hiệu quả các dải khóa được chọn.
Kho cột rộng mang lại tính sẵn sàng cao và khả năng mở rộng cao. Chúng thường được dùng cho các tập dữ liệu rất lớn.
Nguồn và đọc thêm: kho cột rộng
Cơ sở dữ liệu đồ thị (Graph database)
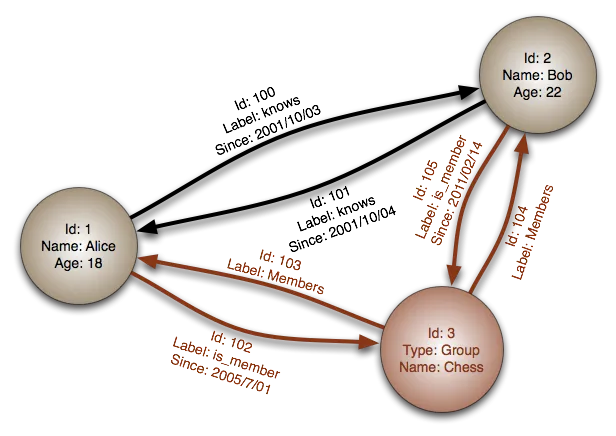
Trừu tượng hóa: đồ thị (graph)
Trong cơ sở dữ liệu đồ thị, mỗi nút (node) là một bản ghi và mỗi cung (arc) là một quan hệ giữa hai nút. Cơ sở dữ liệu đồ thị được tối ưu để biểu diễn các quan hệ phức tạp với nhiều khóa ngoại (foreign key) hoặc nhiều quan hệ nhiều - nhiều (many-to-many).
Cơ sở dữ liệu đồ thị cho hiệu năng cao với các mô hình dữ liệu có quan hệ phức tạp, chẳng hạn một mạng xã hội. Chúng còn tương đối mới và chưa được dùng rộng rãi; có thể khó tìm công cụ phát triển và tài liệu hơn. Nhiều cơ sở dữ liệu đồ thị chỉ có thể truy cập qua REST API.
Nguồn và đọc thêm: đồ thị
Nguồn và đọc thêm: NoSQL
- Explanation of base terminology
- NoSQL databases a survey and decision guidance
- Scalability
- Introduction to NoSQL
- NoSQL patterns
SQL hay NoSQL
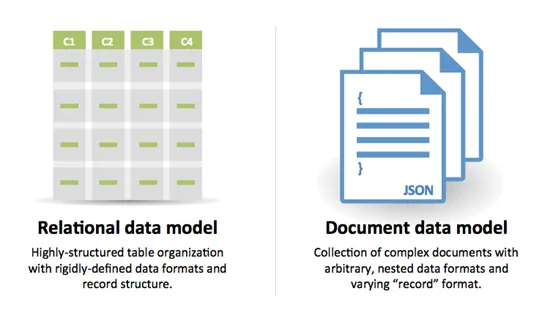
Lý do chọn SQL:
- Dữ liệu có cấu trúc
- Lược đồ chặt chẽ
- Dữ liệu có quan hệ
- Cần các phép join phức tạp
- Giao dịch
- Có các mẫu mở rộng rõ ràng
- Lâu đời, vững chắc hơn: lập trình viên, cộng đồng, code, công cụ, v.v.
- Tra cứu theo chỉ mục rất nhanh
Lý do chọn NoSQL:
- Dữ liệu bán cấu trúc (semi-structured)
- Lược đồ động hoặc linh hoạt
- Dữ liệu phi quan hệ
- Không cần join phức tạp
- Lưu trữ nhiều TB (hoặc PB) dữ liệu
- Khối lượng công việc rất nặng về dữ liệu
- Thông lượng IOPS rất cao
Dữ liệu mẫu rất phù hợp với NoSQL:
- Thu nạp nhanh dữ liệu luồng nhấp chuột (clickstream) và log
- Dữ liệu bảng xếp hạng hoặc tính điểm
- Dữ liệu tạm thời, chẳng hạn giỏ hàng
- Các bảng được truy cập thường xuyên (bảng "nóng")
- Bảng siêu dữ liệu/bảng tra cứu