Thiết kế hệ thống mở rộng tới hàng triệu người dùng trên AWS
Nội dung gốc
Lưu ý: Tài liệu này liên kết thẳng tới các phần liên quan trong danh mục chủ đề system design để tránh lặp lại. Hãy tham khảo nội dung được liên kết để nắm các ý chính cần trình bày, các đánh đổi (tradeoff) và các phương án thay thế.
Bước 1: Phác thảo các trường hợp sử dụng và ràng buộc
Thu thập yêu cầu và khoanh vùng bài toán. Đặt câu hỏi để làm rõ các trường hợp sử dụng (use case) và ràng buộc (constraint). Thảo luận các giả định.
Vì không có người phỏng vấn để trả lời các câu hỏi làm rõ, ta sẽ tự định nghĩa một số trường hợp sử dụng và ràng buộc.
Các trường hợp sử dụng (use cases)
Giải bài toán này theo cách tiếp cận lặp: 1) Đo hiệu năng/Kiểm thử tải (Benchmark/Load Test), 2) Phân tích hiệu năng (Profile) để tìm nút thắt cổ chai (bottleneck), 3) xử lý nút thắt đồng thời đánh giá các phương án thay thế và đánh đổi, và 4) lặp lại. Đây là một khuôn mẫu tốt để phát triển các thiết kế cơ bản thành thiết kế có khả năng mở rộng.
Trừ khi bạn có nền tảng về AWS hoặc đang ứng tuyển vào vị trí đòi hỏi kiến thức AWS, các chi tiết riêng của AWS không phải là yêu cầu bắt buộc. Tuy nhiên, phần lớn các nguyên tắc được bàn trong bài tập này có thể áp dụng rộng rãi bên ngoài hệ sinh thái AWS.
Ta khoanh vùng bài toán, chỉ xử lý các trường hợp sử dụng sau
- Người dùng gửi một yêu cầu đọc hoặc ghi
- Dịch vụ xử lý, lưu dữ liệu người dùng, rồi trả về kết quả
- Dịch vụ cần phát triển từ phục vụ một lượng nhỏ người dùng tới hàng triệu người dùng
- Thảo luận các mẫu mở rộng chung khi ta phát triển kiến trúc để xử lý lượng lớn người dùng và yêu cầu
- Dịch vụ có tính sẵn sàng cao (high availability)
Ràng buộc và giả định
Nêu các giả định
- Lưu lượng truy cập không phân bố đều
- Cần dữ liệu quan hệ (relational data)
- Mở rộng từ 1 người dùng lên hàng chục triệu người dùng
- Ký hiệu mức tăng người dùng là:
- Users+
- Users++
- Users+++
- ...
- 10 triệu người dùng
- 1 tỷ lượt ghi mỗi tháng
- 100 tỷ lượt đọc mỗi tháng
- Tỷ lệ đọc/ghi là 100:1
- 1 KB nội dung mỗi lượt ghi
- Ký hiệu mức tăng người dùng là:
Tính toán mức sử dụng
Hãy hỏi rõ người phỏng vấn xem bạn có nên làm các phép ước lượng nhanh (back-of-the-envelope) về mức sử dụng hay không.
- 1 TB nội dung mới mỗi tháng
- 1 KB mỗi lượt ghi * 1 tỷ lượt ghi mỗi tháng
- 36 TB nội dung mới trong 3 năm
- Giả định phần lớn lượt ghi là nội dung mới chứ không phải cập nhật nội dung cũ
- Trung bình 400 lượt ghi mỗi giây
- Trung bình 40.000 lượt đọc mỗi giây
Bảng quy đổi tiện dụng:
- 2,5 triệu giây mỗi tháng
- 1 yêu cầu mỗi giây = 2,5 triệu yêu cầu mỗi tháng
- 40 yêu cầu mỗi giây = 100 triệu yêu cầu mỗi tháng
- 400 yêu cầu mỗi giây = 1 tỷ yêu cầu mỗi tháng
Bước 2: Tạo thiết kế tổng quan (high level design)
Phác thảo thiết kế tổng quan với tất cả các thành phần quan trọng.
Bước 3: Thiết kế các thành phần cốt lõi
Đi sâu vào chi tiết từng thành phần cốt lõi.
Trường hợp sử dụng: Người dùng gửi một yêu cầu đọc hoặc ghi
Mục tiêu
- Với chỉ 1-2 người dùng, bạn chỉ cần một cấu hình cơ bản
- Một máy duy nhất cho đơn giản
- Mở rộng theo chiều dọc (vertical scaling) khi cần
- Giám sát để xác định nút thắt
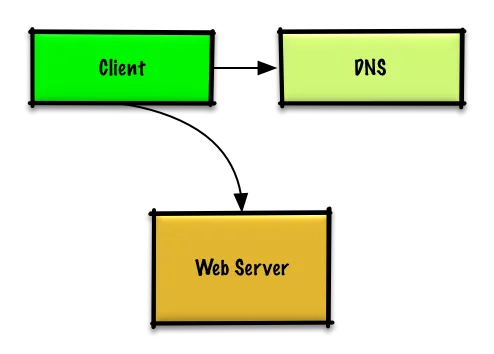
Bắt đầu với một máy duy nhất
- Web server chạy trên EC2
- Lưu trữ dữ liệu người dùng
- Cơ sở dữ liệu MySQL
Dùng mở rộng theo chiều dọc (Vertical Scaling):
- Đơn giản là chọn một máy mạnh hơn
- Theo dõi các chỉ số (metric) để quyết định cách nâng cấp
- Dùng giám sát cơ bản để xác định nút thắt: CPU, bộ nhớ, IO, mạng, v.v.
- CloudWatch, top, nagios, statsd, graphite, v.v.
- Mở rộng theo chiều dọc có thể trở nên rất đắt
- Không có dự phòng (redundancy) hay chuyển đổi dự phòng (failover)
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Phương án thay thế cho mở rộng theo chiều dọc là mở rộng theo chiều ngang (horizontal scaling)
Bắt đầu với SQL, cân nhắc NoSQL
Các ràng buộc giả định rằng cần dữ liệu quan hệ. Ta có thể bắt đầu bằng một cơ sở dữ liệu MySQL trên chính máy duy nhất đó.
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem mục Hệ quản trị cơ sở dữ liệu quan hệ (RDBMS)
- Thảo luận lý do dùng SQL hay NoSQL
Gán một IP tĩnh công khai
- Elastic IP cung cấp một điểm truy cập (endpoint) công khai có IP không đổi khi khởi động lại
- Giúp ích cho failover: chỉ cần trỏ tên miền sang IP mới
Dùng DNS
Thêm một DNS như Route 53 để ánh xạ tên miền tới IP công khai của máy (instance).
Đánh đổi, phương án thay thế và chi tiết bổ sung:
Bảo mật web server
- Chỉ mở những cổng cần thiết
- Cho phép web server phản hồi các yêu cầu đến từ:
- Cổng 80 cho HTTP
- Cổng 443 cho HTTPS
- Cổng 22 cho SSH, chỉ từ các IP trong danh sách cho phép (whitelist)
- Ngăn web server tự khởi tạo kết nối ra ngoài
- Cho phép web server phản hồi các yêu cầu đến từ:
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem mục Bảo mật (Security)
Bước 4: Mở rộng thiết kế (scale the design)
Xác định và xử lý các nút thắt, dựa trên các ràng buộc.
Users+
Giả định
Số người dùng bắt đầu tăng và tải trên máy duy nhất ngày càng lớn. Kết quả Benchmark/Load Test và Profiling chỉ ra rằng cơ sở dữ liệu MySQL chiếm ngày càng nhiều bộ nhớ và CPU, trong khi nội dung người dùng đang lấp đầy ổ đĩa.
Cho tới giờ ta đã xử lý được các vấn đề này bằng mở rộng theo chiều dọc. Không may, cách này đã trở nên khá đắt và không cho phép mở rộng cơ sở dữ liệu MySQL và Web Server một cách độc lập.
Mục tiêu
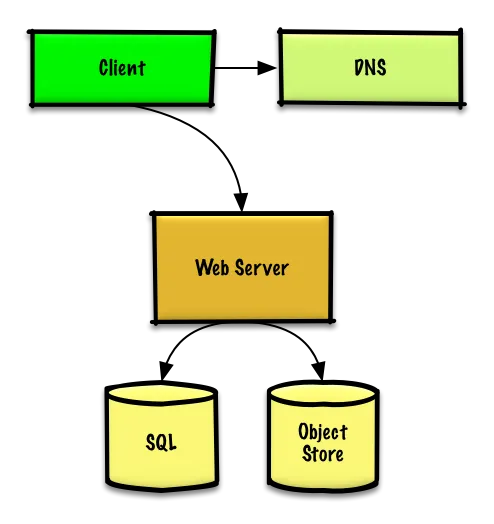
- Giảm tải cho máy duy nhất và cho phép mở rộng độc lập
- Lưu nội dung tĩnh riêng trong một kho lưu trữ đối tượng (Object Store)
- Chuyển cơ sở dữ liệu MySQL sang một máy riêng
- Nhược điểm
- Những thay đổi này làm tăng độ phức tạp và đòi hỏi sửa Web Server để trỏ tới Object Store và cơ sở dữ liệu MySQL
- Phải áp dụng thêm biện pháp bảo mật cho các thành phần mới
- Chi phí AWS cũng có thể tăng, nhưng cần cân nhắc so với chi phí tự quản lý các hệ thống tương tự
Lưu nội dung tĩnh riêng
- Cân nhắc dùng một Object Store được quản lý sẵn như S3 để lưu nội dung tĩnh
- Khả năng mở rộng và độ tin cậy cao
- Mã hóa phía máy chủ (server side encryption)
- Chuyển nội dung tĩnh sang S3
- Tệp của người dùng
- JS
- CSS
- Hình ảnh
- Video
Chuyển cơ sở dữ liệu MySQL sang một máy riêng
- Cân nhắc dùng một dịch vụ như RDS để quản lý cơ sở dữ liệu MySQL
- Dễ quản trị, dễ mở rộng
- Nhiều vùng sẵn sàng (availability zone)
- Mã hóa dữ liệu lưu trữ (encryption at rest)
Bảo mật hệ thống
- Mã hóa dữ liệu khi truyền (in transit) và khi lưu trữ (at rest)
- Dùng một mạng riêng ảo (Virtual Private Cloud - VPC)
- Tạo một mạng con công khai (public subnet) cho Web Server duy nhất để nó có thể gửi và nhận lưu lượng từ internet
- Tạo một mạng con riêng (private subnet) cho mọi thứ còn lại, ngăn truy cập từ bên ngoài
- Với mỗi thành phần, chỉ mở cổng cho các IP trong whitelist
- Các mẫu tương tự nên được áp dụng cho các thành phần mới trong phần còn lại của bài tập
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem mục Bảo mật (Security)
Users++
Giả định
Kết quả Benchmark/Load Test và Profiling cho thấy Web Server duy nhất bị nghẽn vào giờ cao điểm, dẫn tới phản hồi chậm và đôi khi ngừng hoạt động (downtime). Khi dịch vụ trưởng thành hơn, ta cũng muốn tiến tới tính sẵn sàng và dự phòng cao hơn.
Mục tiêu
- Các mục tiêu sau nhằm xử lý vấn đề mở rộng của Web Server
- Dựa trên kết quả Benchmark/Load Test và Profiling, có thể bạn chỉ cần triển khai một hoặc hai kỹ thuật trong số này
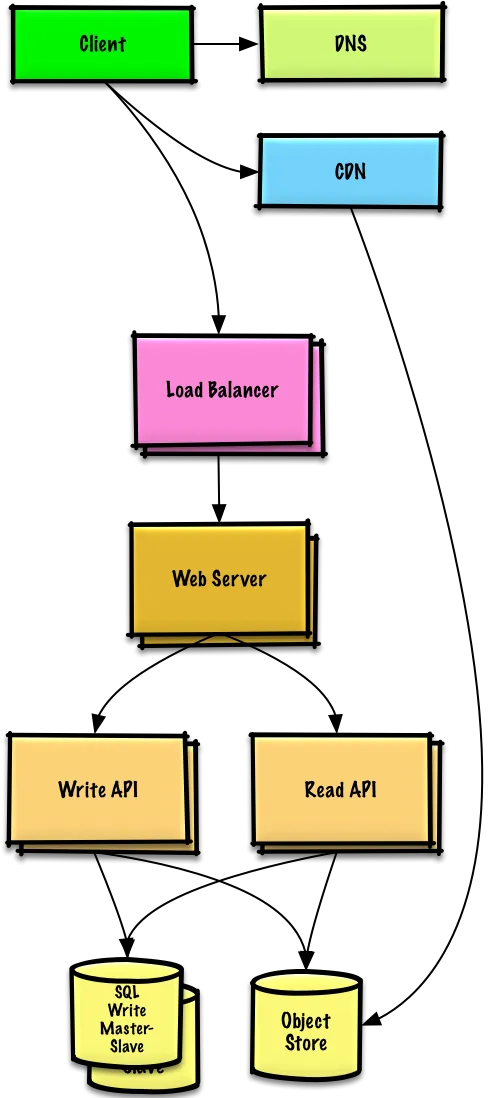
- Dùng mở rộng theo chiều ngang (Horizontal Scaling) để xử lý tải tăng dần và loại bỏ điểm lỗi đơn (single point of failure)
- Thêm một bộ cân bằng tải (Load Balancer) như ELB của Amazon hoặc HAProxy
- ELB có tính sẵn sàng cao
- Nếu tự cấu hình Load Balancer, việc dựng nhiều máy chủ ở chế độ active-active hoặc active-passive trên nhiều vùng sẵn sàng sẽ cải thiện tính sẵn sàng
- Kết thúc SSL (terminate SSL) tại Load Balancer để giảm tải tính toán cho các máy chủ phía sau và đơn giản hóa việc quản lý chứng chỉ
- Dùng nhiều Web Server trải trên nhiều vùng sẵn sàng
- Dùng nhiều instance MySQL ở chế độ Master-Slave Failover trên nhiều vùng sẵn sàng để tăng dự phòng
- Thêm một bộ cân bằng tải (Load Balancer) như ELB của Amazon hoặc HAProxy
- Tách Web Server khỏi Application Server
- Mở rộng và cấu hình hai tầng một cách độc lập
- Web Server có thể chạy như một Reverse Proxy
- Ví dụ, bạn có thể thêm các Application Server xử lý Read API trong khi các máy khác xử lý Write API
- Chuyển nội dung tĩnh (và một phần nội dung động) sang một mạng phân phối nội dung (Content Delivery Network - CDN) như CloudFront để giảm tải và giảm độ trễ
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem nội dung được liên kết ở trên để biết chi tiết
Users+++
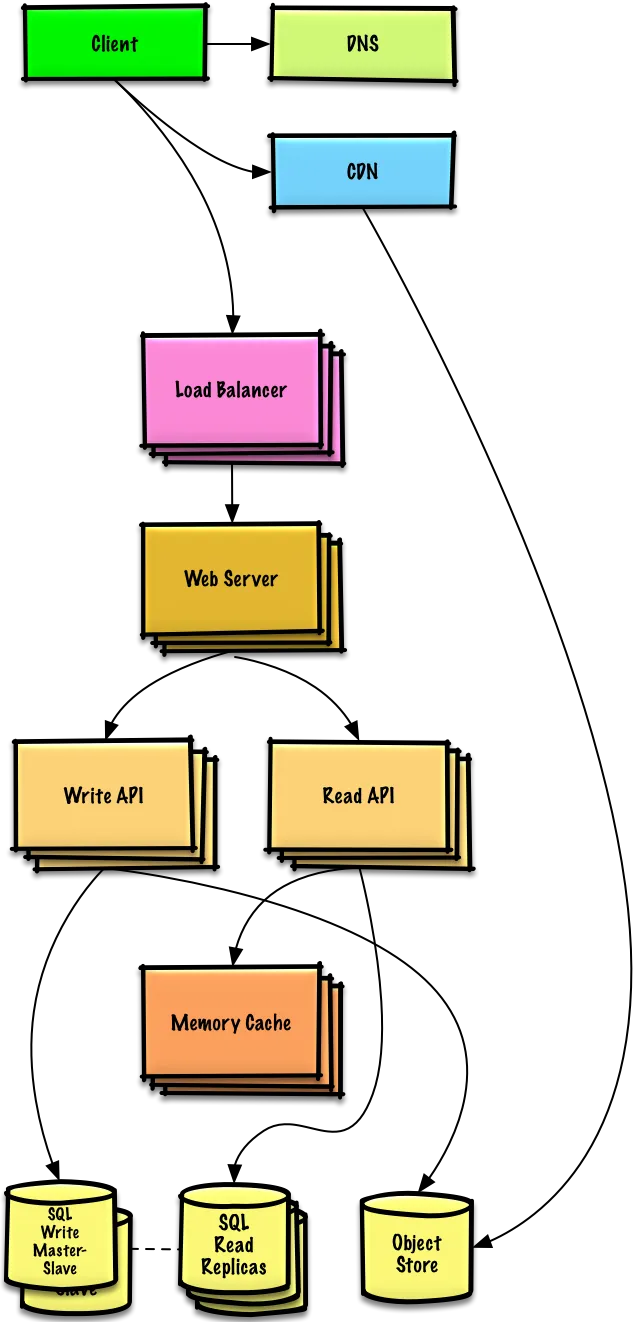
Lưu ý: Các Load Balancer nội bộ không được vẽ để sơ đồ đỡ rối
Giả định
Kết quả Benchmark/Load Test và Profiling cho thấy hệ thống thiên về đọc (read-heavy, đọc gấp 100 lần ghi) và cơ sở dữ liệu đang có hiệu năng kém do lượng yêu cầu đọc lớn.
Mục tiêu
- Các mục tiêu sau nhằm xử lý vấn đề mở rộng của cơ sở dữ liệu MySQL
- Dựa trên kết quả Benchmark/Load Test và Profiling, có thể bạn chỉ cần triển khai một hoặc hai kỹ thuật trong số này
- Chuyển các dữ liệu sau vào một bộ nhớ đệm trong bộ nhớ (Memory Cache) như Elasticache để giảm tải và giảm độ trễ:
- Nội dung được truy cập thường xuyên từ MySQL
- Trước tiên, hãy thử cấu hình cache của cơ sở dữ liệu MySQL xem có đủ giải tỏa nút thắt không, trước khi triển khai Memory Cache
- Dữ liệu phiên (session) từ các Web Server
- Web Server trở nên phi trạng thái (stateless), cho phép tự động co giãn (Autoscaling)
- Đọc tuần tự 1 MB từ bộ nhớ mất khoảng 250 micro giây, trong khi đọc từ SSD lâu hơn 4 lần và từ đĩa cứng lâu hơn 80 lần.1
- Nội dung được truy cập thường xuyên từ MySQL
- Thêm MySQL Read Replicas để giảm tải cho master ghi
- Thêm Web Server và Application Server để cải thiện khả năng phản hồi
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem nội dung được liên kết ở trên để biết chi tiết
Thêm MySQL read replica
- Bên cạnh việc thêm và mở rộng Memory Cache, MySQL Read Replicas cũng giúp giảm tải cho MySQL Write Master
- Thêm logic vào Web Server để tách riêng thao tác ghi và đọc
- Thêm Load Balancer phía trước MySQL Read Replicas (không vẽ để sơ đồ đỡ rối)
- Phần lớn dịch vụ thiên về đọc hơn là thiên về ghi
Đánh đổi, phương án thay thế và chi tiết bổ sung:
Users++++
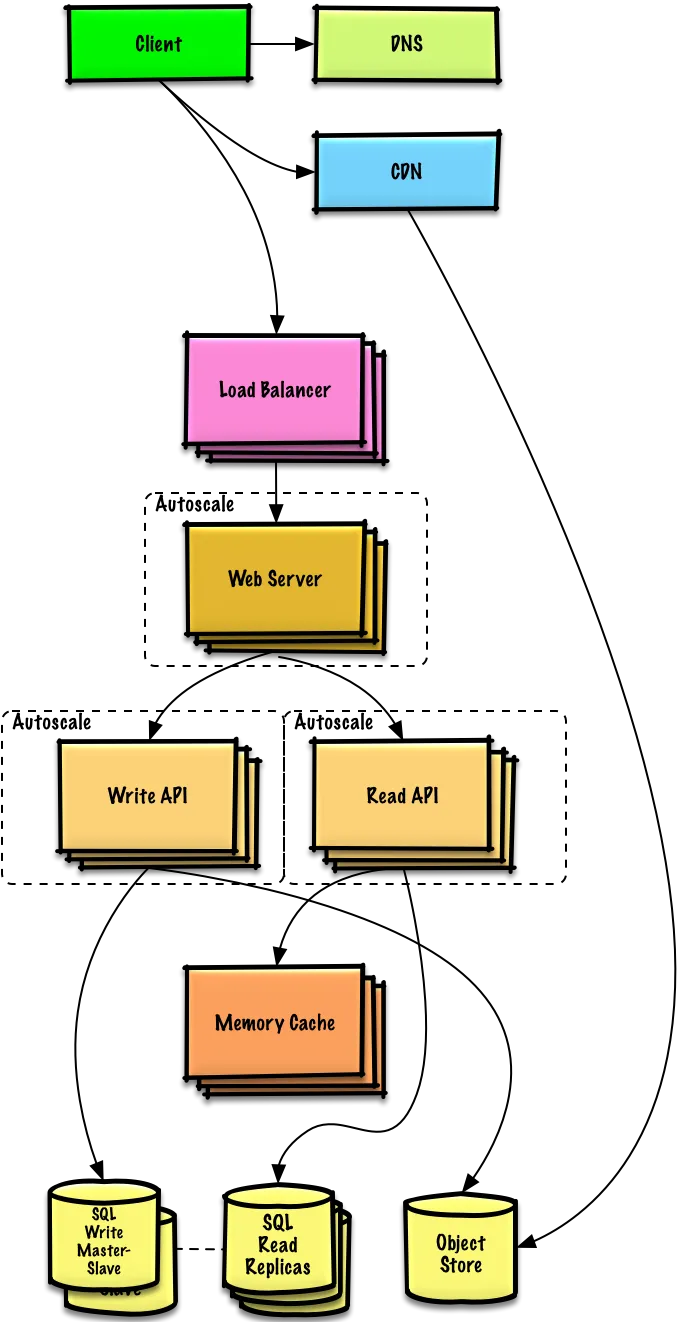
Giả định
Kết quả Benchmark/Load Test và Profiling cho thấy lưu lượng tăng vọt trong giờ hành chính ở Mỹ và giảm mạnh khi người dùng rời văn phòng. Ta nghĩ có thể cắt giảm chi phí bằng cách tự động bật và tắt máy chủ theo tải thực tế. Ta là một đội nhỏ nên muốn tự động hóa DevOps nhiều nhất có thể cho Autoscaling và cho vận hành nói chung.
Mục tiêu
- Thêm Autoscaling để cấp phát tài nguyên theo nhu cầu
- Theo kịp các đợt tăng lưu lượng đột biến
- Giảm chi phí bằng cách tắt các instance không dùng
- Tự động hóa DevOps
- Chef, Puppet, Ansible, v.v.
- Tiếp tục giám sát các chỉ số để xử lý nút thắt
- Mức máy (host level) - Xem xét từng instance EC2
- Mức tổng hợp (aggregate level) - Xem xét số liệu thống kê của load balancer
- Phân tích log - CloudWatch, CloudTrail, Loggly, Splunk, Sumo
- Hiệu năng trang web nhìn từ bên ngoài - Pingdom hoặc New Relic
- Xử lý thông báo và sự cố - PagerDuty
- Báo cáo lỗi - Sentry
Thêm autoscaling
- Cân nhắc một dịch vụ được quản lý như AWS Autoscaling
- Tạo một nhóm cho mỗi loại Web Server và một nhóm cho mỗi loại Application Server, đặt mỗi nhóm trên nhiều vùng sẵn sàng
- Đặt số instance tối thiểu và tối đa
- Kích hoạt tăng và giảm quy mô thông qua CloudWatch
- Chỉ số đơn giản theo giờ trong ngày cho các tải dự đoán được, hoặc
- Các chỉ số trong một khoảng thời gian:
- Tải CPU
- Độ trễ
- Lưu lượng mạng
- Chỉ số tùy chỉnh
- Nhược điểm
- Autoscaling có thể làm tăng độ phức tạp
- Có thể mất một khoảng thời gian trước khi hệ thống tăng quy mô tương xứng với nhu cầu tăng, hoặc giảm quy mô khi nhu cầu giảm
Users+++++
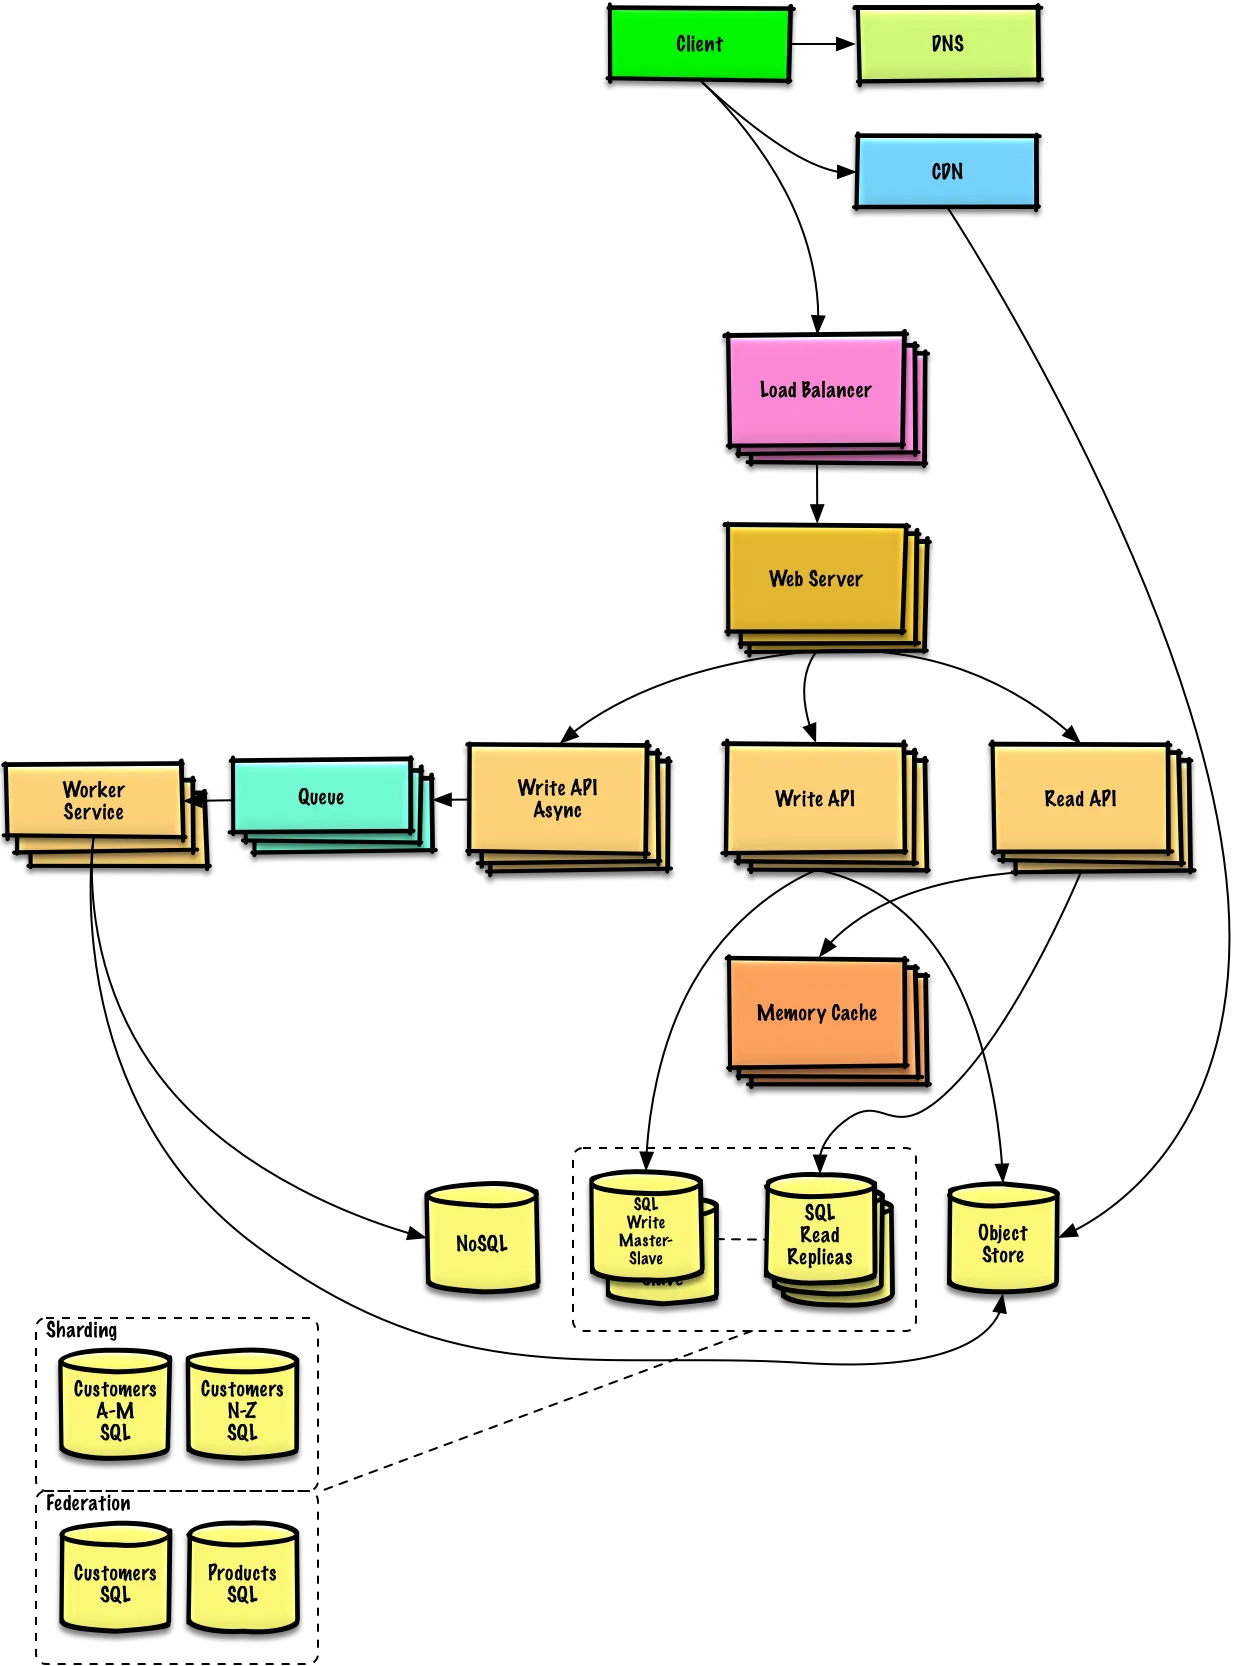
Lưu ý: Các nhóm Autoscaling không được vẽ để sơ đồ đỡ rối
Giả định
Khi dịch vụ tiếp tục tăng trưởng hướng tới các con số nêu trong ràng buộc, ta lặp lại việc chạy Benchmark/Load Test và Profiling để phát hiện và xử lý các nút thắt mới.
Mục tiêu
Ta sẽ tiếp tục xử lý các vấn đề mở rộng do ràng buộc của bài toán:
- Nếu cơ sở dữ liệu MySQL bắt đầu phình quá lớn, ta có thể cân nhắc chỉ lưu dữ liệu trong một khoảng thời gian giới hạn trong cơ sở dữ liệu, còn phần còn lại lưu trong một kho dữ liệu (data warehouse) như Redshift
- Một data warehouse như Redshift có thể thoải mái đáp ứng ràng buộc 1 TB nội dung mới mỗi tháng
- Với trung bình 40.000 yêu cầu đọc mỗi giây, lưu lượng đọc cho nội dung phổ biến có thể được xử lý bằng cách mở rộng Memory Cache, vốn cũng hữu ích để xử lý lưu lượng phân bố không đều và các đợt tăng đột biến
- SQL Read Replicas có thể gặp khó khăn khi xử lý các lần trượt cache (cache miss), nhiều khả năng ta sẽ cần áp dụng thêm các mẫu mở rộng SQL
- Trung bình 400 lượt ghi mỗi giây (với đỉnh có lẽ cao hơn đáng kể) có thể là quá sức với một SQL Write Master-Slave duy nhất, cũng cho thấy cần thêm các kỹ thuật mở rộng
Các mẫu mở rộng SQL gồm:
- Liên kết (federation)
- Phân mảnh (sharding)
- Phi chuẩn hóa (denormalization)
- Tinh chỉnh SQL (SQL tuning)
Để xử lý thêm lượng yêu cầu đọc và ghi cao, ta cũng nên cân nhắc chuyển những dữ liệu phù hợp sang một cơ sở dữ liệu NoSQL như DynamoDB.
Ta có thể tách tiếp các Application Server để mở rộng độc lập. Các tiến trình theo lô (batch) hoặc các phép tính không cần thực hiện theo thời gian thực có thể làm bất đồng bộ (asynchronously) với hàng đợi (Queue) và Worker:
- Ví dụ, trong một dịch vụ ảnh, việc tải ảnh lên và việc tạo ảnh thu nhỏ (thumbnail) có thể được tách riêng:
- Client tải ảnh lên
- Application Server đặt một công việc (job) vào một Queue như SQS
- Worker Service trên EC2 hoặc Lambda lấy công việc ra khỏi Queue rồi:
- Tạo thumbnail
- Cập nhật cơ sở dữ liệu
- Lưu thumbnail vào Object Store
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem nội dung được liên kết ở trên để biết chi tiết
Các ý bàn thêm (additional talking points)
Các chủ đề bổ sung để đào sâu, tùy vào phạm vi bài toán và thời gian còn lại.
Các mẫu mở rộng SQL
- Bản sao chỉ đọc (read replicas)
- Liên kết (federation)
- Phân mảnh (sharding)
- Phi chuẩn hóa (denormalization)
- Tinh chỉnh SQL (SQL tuning)
NoSQL
- Kho khóa-giá trị (key-value store)
- Kho tài liệu (document store)
- Kho cột rộng (wide column store)
- Cơ sở dữ liệu đồ thị (graph database)
- SQL hay NoSQL
Bộ nhớ đệm (caching)
- Cache ở đâu
- Cache cái gì
- Khi nào cập nhật cache
Bất đồng bộ (asynchronism) và microservices
- Hàng đợi thông điệp (message queues)
- Hàng đợi tác vụ (task queues)
- Áp lực ngược (back pressure)
- Microservices
Giao tiếp (communications)
- Thảo luận các đánh đổi:
- Giao tiếp bên ngoài với client - HTTP API theo REST
- Giao tiếp nội bộ - RPC
- Khám phá dịch vụ (service discovery)
Bảo mật (security)
Tham khảo phần bảo mật.
Các con số độ trễ
Xem Các con số độ trễ mọi lập trình viên nên biết (Latency numbers every programmer should know).
Tiếp tục
- Tiếp tục đo hiệu năng và giám sát hệ thống để xử lý các nút thắt khi chúng xuất hiện
- Mở rộng quy mô là một quá trình lặp đi lặp lại