Thiết kế tính năng xếp hạng bán chạy theo danh mục của Amazon (sales rank)
Nội dung gốc
Lưu ý: Tài liệu này liên kết trực tiếp tới các phần liên quan trong danh mục chủ đề system design để tránh lặp lại. Hãy tham khảo nội dung được liên kết để nắm các ý thảo luận chung, các đánh đổi (tradeoff) và phương án thay thế.
Bước 1: Phác thảo use case và ràng buộc
Thu thập yêu cầu và xác định phạm vi bài toán. Đặt câu hỏi để làm rõ use case và ràng buộc. Thảo luận các giả định.
Vì không có người phỏng vấn để trả lời các câu hỏi làm rõ, ta sẽ tự định nghĩa một số use case và ràng buộc.
Use case
Ta giới hạn bài toán chỉ xử lý các use case sau
- Dịch vụ (Service) tính toán các sản phẩm phổ biến nhất trong tuần qua theo từng danh mục
- Người dùng (User) xem các sản phẩm phổ biến nhất trong tuần qua theo từng danh mục
- Dịch vụ có tính sẵn sàng cao (high availability)
Ngoài phạm vi
- Toàn bộ trang thương mại điện tử nói chung
- Chỉ thiết kế các thành phần phục vụ việc tính xếp hạng bán chạy
Ràng buộc và giả định
Các giả định
- Lưu lượng truy cập không phân bố đều
- Một sản phẩm có thể thuộc nhiều danh mục
- Sản phẩm không thể đổi danh mục
- Không có danh mục con, ví dụ
foo/bar/baz - Kết quả phải được cập nhật mỗi giờ
- Các sản phẩm phổ biến hơn có thể cần được cập nhật thường xuyên hơn
- 10 triệu sản phẩm
- 1000 danh mục
- 1 tỷ giao dịch mỗi tháng
- 100 tỷ yêu cầu đọc mỗi tháng
- Tỷ lệ đọc:ghi là 100:1
Tính toán mức sử dụng
Hãy hỏi người phỏng vấn xem bạn có nên thực hiện các phép ước lượng nhanh (back-of-the-envelope) hay không.
- Kích thước mỗi giao dịch:
created_at- 5 byteproduct_id- 8 bytecategory_id- 4 byteseller_id- 8 bytebuyer_id- 8 bytequantity- 4 bytetotal_price- 5 byte- Tổng: ~40 byte
- 40 GB nội dung giao dịch mới mỗi tháng
- 40 byte mỗi giao dịch * 1 tỷ giao dịch mỗi tháng
- 1.44 TB nội dung giao dịch mới trong 3 năm
- Giả định phần lớn là giao dịch mới chứ không phải cập nhật giao dịch cũ
- Trung bình 400 giao dịch mỗi giây
- Trung bình 40,000 yêu cầu đọc mỗi giây
Bảng quy đổi tiện dụng:
- 2.5 triệu giây mỗi tháng
- 1 yêu cầu mỗi giây = 2.5 triệu yêu cầu mỗi tháng
- 40 yêu cầu mỗi giây = 100 triệu yêu cầu mỗi tháng
- 400 yêu cầu mỗi giây = 1 tỷ yêu cầu mỗi tháng
Bước 2: Tạo thiết kế tổng quan (high level design)
Phác thảo thiết kế tổng quan với tất cả các thành phần quan trọng.
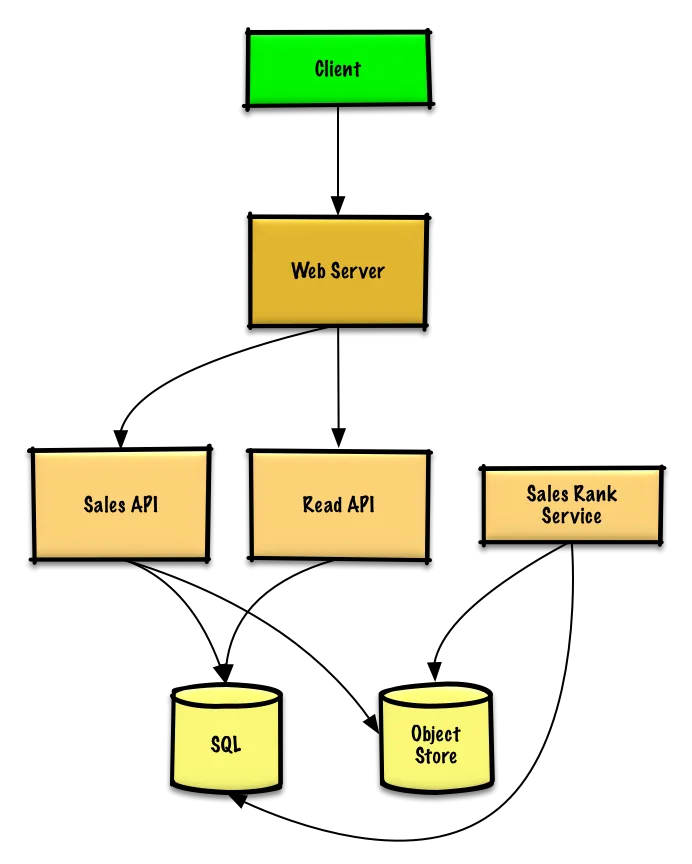
Bước 3: Thiết kế các thành phần cốt lõi
Đi sâu vào chi tiết từng thành phần cốt lõi.
Use case: Dịch vụ tính toán các sản phẩm phổ biến nhất trong tuần qua theo từng danh mục
Ta có thể lưu các file log thô của máy chủ Sales API trên một Object Store được quản lý sẵn (managed) như Amazon S3, thay vì tự vận hành một hệ thống file phân tán (distributed file system).
Hãy hỏi người phỏng vấn xem bạn cần viết bao nhiêu code.
Ta giả định đây là một dòng log mẫu, phân tách bằng tab:
timestamp   product_id  category_id    qty     total_price   seller_id    buyer_id
t1          product1    category1      2       20.00         1            1
t2          product1    category2      2       20.00         2            2
t2          product1    category2      1       10.00         2            3
t3          product2    category1      3        7.00         3            4
t4          product3    category2      7        2.00         4            5
t5          product4    category1      1        5.00         5            6
...
Sales Rank Service có thể dùng MapReduce, lấy các file log của máy chủ Sales API làm đầu vào và ghi kết quả vào bảng tổng hợp sales_rank trong SQL Database. Ta nên thảo luận về các use case và đánh đổi khi chọn SQL hay NoSQL.
Ta sẽ dùng MapReduce nhiều bước:
- Bước 1 - Biến đổi dữ liệu thành
(category, product_id), sum(quantity) - Bước 2 - Thực hiện sắp xếp phân tán (distributed sort)
class SalesRanker(MRJob):

    def within_past_week(self, timestamp):
        """Trả về True nếu timestamp nằm trong tuần qua, ngược lại trả về False."""
        ...

    def mapper(self, _ line):
        """Phân tích từng dòng log, trích xuất và biến đổi các dòng liên quan.

        Phát ra (emit) các cặp key-value có dạng:

        (category1, product1), 2
        (category2, product1), 2
        (category2, product1), 1
        (category1, product2), 3
        (category2, product3), 7
        (category1, product4), 1
        """
        timestamp, product_id, category_id, quantity, total_price, seller_id, \
            buyer_id = line.split('\t')
        if self.within_past_week(timestamp):
            yield (category_id, product_id), quantity

    def reducer(self, key, value):
        """Cộng dồn các giá trị cho mỗi key.

        (category1, product1), 2
        (category2, product1), 3
        (category1, product2), 3
        (category2, product3), 7
        (category1, product4), 1
        """
        yield key, sum(values)

    def mapper_sort(self, key, value):
        """Tạo key sao cho việc sắp xếp diễn ra đúng.

        Biến đổi key và value thành dạng:

        (category1, 2), product1
        (category2, 3), product1
        (category1, 3), product2
        (category2, 7), product3
        (category1, 1), product4

        Bước shuffle/sort của MapReduce sau đó sẽ
        sắp xếp phân tán trên các key, cho ra kết quả:

        (category1, 1), product4
        (category1, 2), product1
        (category1, 3), product2
        (category2, 3), product1
        (category2, 7), product3
        """
        category_id, product_id = key
        quantity = value
        yield (category_id, quantity), product_id

    def reducer_identity(self, key, value):
        yield key, value

    def steps(self):
        """Chạy các bước map và reduce."""
        return [
            self.mr(mapper=self.mapper,
                    reducer=self.reducer),
            self.mr(mapper=self.mapper_sort,
                    reducer=self.reducer_identity),
]Kết quả sẽ là danh sách đã sắp xếp sau đây, mà ta có thể chèn vào bảng sales_rank:
(category1, 1), product4
(category1, 2), product1
(category1, 3), product2
(category2, 3), product1
(category2, 7), product3
Bảng sales_rank có thể có cấu trúc như sau:
id int NOT NULL AUTO_INCREMENT
category_id int NOT NULL
total_sold int NOT NULL
product_id int NOT NULL
PRIMARY KEY(id)
FOREIGN KEY(category_id) REFERENCES Categories(id)
FOREIGN KEY(product_id) REFERENCES Products(id)
Ta sẽ tạo chỉ mục (index) trên id , category_id và product_id để tăng tốc tra cứu (thời gian log thay vì quét toàn bộ bảng) và để giữ dữ liệu trong bộ nhớ. Đọc tuần tự 1 MB từ bộ nhớ mất khoảng 250 micro giây, trong khi đọc từ SSD lâu hơn 4 lần và từ ổ đĩa (disk) lâu hơn 80 lần.1
Use case: Người dùng xem các sản phẩm phổ biến nhất trong tuần qua theo từng danh mục
- Client gửi yêu cầu tới Web Server, đang chạy dưới dạng reverse proxy
- Web Server chuyển tiếp yêu cầu tới máy chủ Read API
- Máy chủ Read API đọc từ bảng
sales_ranktrong SQL Database
Ta sẽ dùng một REST API công khai:
$ curl https://amazon.com/api/v1/popular?category_id=1234Phản hồi:
{
    "id": "100",
    "category_id": "1234",
    "total_sold": "100000",
    "product_id": "50",
},
{
    "id": "53",
    "category_id": "1234",
    "total_sold": "90000",
    "product_id": "200",
},
{
    "id": "75",
    "category_id": "1234",
    "total_sold": "80000",
    "product_id": "3",
},
Với giao tiếp nội bộ, ta có thể dùng gọi thủ tục từ xa (Remote Procedure Call - RPC).
Bước 4: Mở rộng thiết kế (scale)
Xác định và xử lý các điểm nghẽn (bottleneck), dựa trên các ràng buộc.
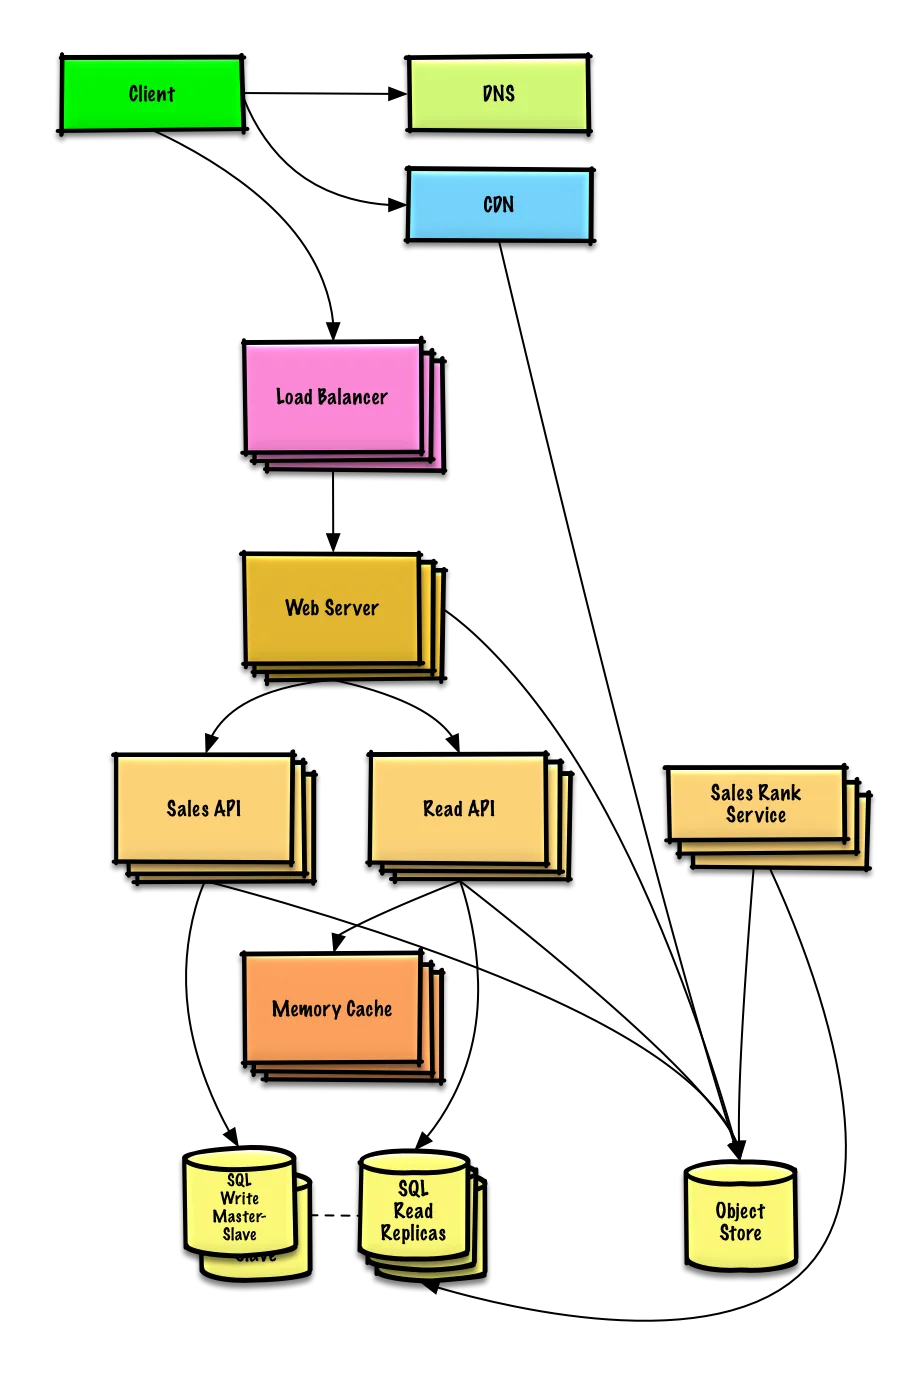
Quan trọng: Đừng nhảy thẳng từ thiết kế ban đầu sang thiết kế cuối cùng!
Hãy nói rõ rằng bạn sẽ 1) Đo hiệu năng/Kiểm thử tải (Benchmark/Load Test), 2) Phân tích (Profile) để tìm điểm nghẽn, 3) xử lý các điểm nghẽn trong khi đánh giá các phương án thay thế và đánh đổi, và 4) lặp lại. Xem Thiết kế hệ thống phục vụ hàng triệu người dùng trên AWS làm ví dụ về cách mở rộng thiết kế ban đầu theo từng vòng lặp.
Điều quan trọng là thảo luận những điểm nghẽn có thể gặp với thiết kế ban đầu và cách xử lý từng điểm. Ví dụ: thêm Load Balancer với nhiều Web Server giải quyết được vấn đề gì? CDN? Master-Slave Replicas? Các phương án thay thế và đánh đổi của từng lựa chọn là gì?
Ta sẽ bổ sung một số thành phần để hoàn thiện thiết kế và xử lý các vấn đề về khả năng mở rộng. Các load balancer nội bộ không được vẽ để hình đỡ rối.
Để tránh lặp lại các thảo luận, hãy tham khảo các chủ đề system design sau để nắm các ý chính, đánh đổi và phương án thay thế:
- DNS
- CDN
- Load balancer
- Mở rộng theo chiều ngang (horizontal scaling)
- Web server (reverse proxy)
- API server (tầng ứng dụng - application layer)
- Cache
- Hệ quản trị cơ sở dữ liệu quan hệ (RDBMS)
- Fail-over master-slave cho SQL ghi
- Nhân bản master-slave (master-slave replication)
- Các mẫu nhất quán (consistency patterns)
- Các mẫu sẵn sàng (availability patterns)
Analytics Database có thể dùng giải pháp kho dữ liệu (data warehouse) như Amazon Redshift hoặc Google BigQuery.
Ta có thể chỉ muốn lưu dữ liệu trong một khoảng thời gian giới hạn trong cơ sở dữ liệu, phần còn lại lưu trong data warehouse hoặc trong Object Store. Một Object Store như Amazon S3 có thể dễ dàng đáp ứng ràng buộc 40 GB nội dung mới mỗi tháng.
Để xử lý 40,000 yêu cầu đọc mỗi giây trung bình (cao hơn vào giờ cao điểm), lưu lượng cho nội dung phổ biến (và xếp hạng bán chạy của chúng) nên được xử lý bởi Memory Cache thay vì cơ sở dữ liệu. Memory Cache cũng hữu ích để xử lý lưu lượng phân bố không đều và các đợt tăng đột biến (spike). Với lượng đọc lớn như vậy, SQL Read Replicas có thể không kham nổi các lần cache miss. Nhiều khả năng ta sẽ cần áp dụng thêm các mẫu mở rộng SQL.
400 thao tác ghi mỗi giây trung bình (cao hơn vào giờ cao điểm) có thể là quá sức với một SQL Write Master-Slave duy nhất, điều này cũng cho thấy cần thêm các kỹ thuật mở rộng.
Các mẫu mở rộng SQL gồm:
- Liên kết (federation)
- Phân mảnh (sharding)
- Phi chuẩn hóa (denormalization)
- Tinh chỉnh SQL (SQL tuning)
Ta cũng nên cân nhắc chuyển một phần dữ liệu sang NoSQL Database.
Các ý thảo luận thêm (Additional talking points)
Các chủ đề bổ sung để đào sâu, tùy vào phạm vi bài toán và thời gian còn lại.
NoSQL
- Kho key-value (key-value store)
- Kho tài liệu (document store)
- Kho cột rộng (wide column store)
- Cơ sở dữ liệu đồ thị (graph database)
- SQL vs NoSQL
Caching
- Cache ở đâu
- Cache cái gì
- Khi nào cập nhật cache
Bất đồng bộ và microservices
- Hàng đợi thông điệp (message queues)
- Hàng đợi tác vụ (task queues)
- Áp lực ngược (back pressure)
- Microservices
Giao tiếp (communications)
- Thảo luận các đánh đổi:
- Giao tiếp bên ngoài với client - HTTP API theo REST
- Giao tiếp nội bộ - RPC
- Khám phá dịch vụ (service discovery)
Bảo mật
Tham khảo phần bảo mật.
Các con số về độ trễ
Xem Các con số về độ trễ mà mọi lập trình viên nên biết.
Liên tục
- Tiếp tục đo hiệu năng và giám sát hệ thống để xử lý các điểm nghẽn khi chúng xuất hiện
- Mở rộng hệ thống là một quá trình lặp đi lặp lại